Jev 实测:三道维基百科寻路题,对比 API 模型与自部署小模型
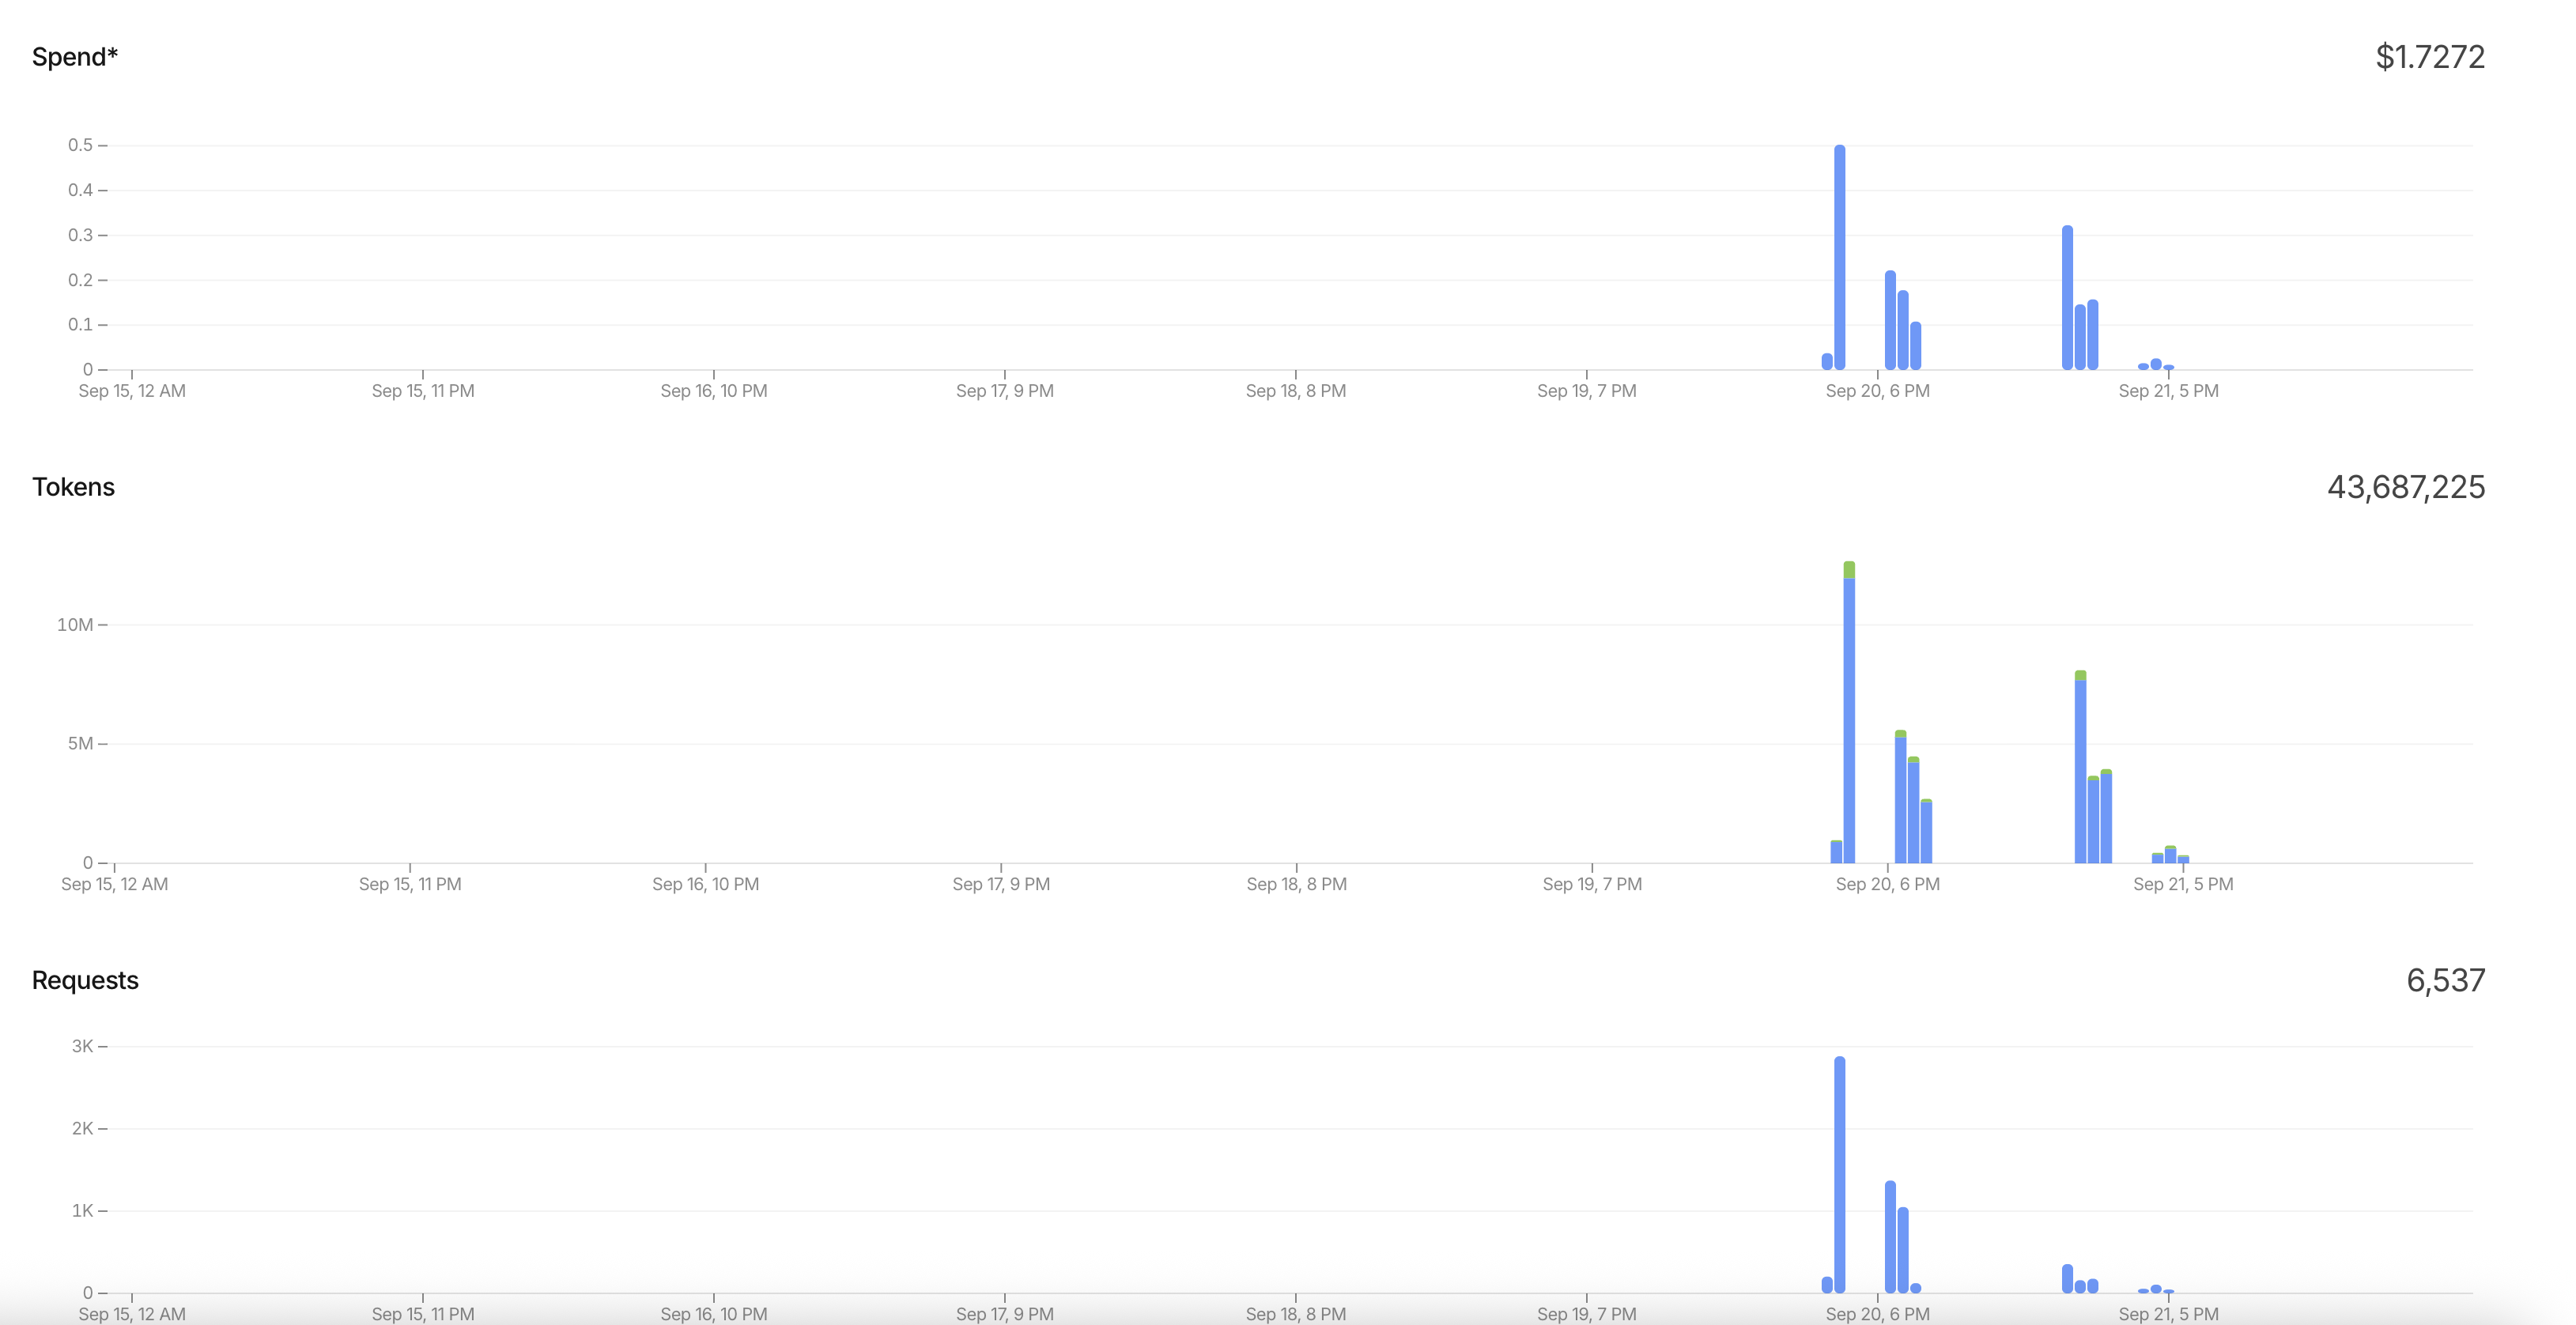
最近看到 Jev 的讨论挺多,我也申请了一下 waitlist,第二天就通过了。当时注册之后送了 5 美元额度,就想拿来试试。
它有一个演示 demo,我看着挺有意思:在维基百科上给两个看起来毫不相关的主题,从第一个页面出发,只点击页面里的文章链接,看看多少步能到第二个主题。这里的点击对象就是页面实际展示的 HTML <a> 链接,不能直接搜索或输入目标网址。
当时我没找到这个 demo 的完整开源实现,所以就自己按这个玩法搭了一套测试。除了 Jev,也试了 SemIf、Laya 这些相关的开源方案,以及几个通过 API 调用的模型。SemIf、Laya 并不是 Jev 的开源权重,我这套程序也不等于官方 demo 的精确复刻。
一开始只在 Mac 上跑本地模型,感觉比较慢。后来又把 Qwen 3.5 4B 和 Gemma 4 E4B 放到 Kaggle 的 T4 上跑了一遍,结果比最初的判断更有意思。下面把本地和远程的数据放在一起。
数据更新到 2026 年 9 月 22 日。主表覆盖 13 个部署配置、39 条正式任务记录;同一个模型在 Mac 和 Kaggle 上算两套配置,不是两个不同模型。
我是怎么测的
这次固定测了三组起点和终点:
| 题目 | 起点 | 终点 |
|---|---|---|
| DNA | DNA | Manipuri pony |
| Music | Music | 2001 AAA Championships |
| World War II | World War II | Bald Mountain Recreation Area |
每次选择时,模型拿到目标和当前页面的标题、简介、最近六步的路径,以及当前页合格链接的标题和短上下文。所有候选都会参加比较,每组最多 255 个;如果一页链接太多,就分组选出候选,再让各组胜者继续比较。过滤和输入预算使用共同规则。
每题最多跑 60 分钟。表里的“点击”是实际跳转次数,不是模型调用次数;“动作耗时”包含模型选择、网页导航和页面观察,不包含模型下载、加载、环境安装和正式计时前的准备。失败题已经消耗的点击和时间也算进去。
运行位置分三类:Mac 本地是 M1 Max、24 核 GPU、32 GB 统一内存;Kaggle 上是 T4,浏览器和评测脚本也一起搬过去了;API 模型则由服务商推理,浏览器仍在我的 Mac 上。Qwen 在 Kaggle 实际用一张 T4,Gemma 把权重分布在两张 T4 上,不是两份模型并行跑题。
三道题的整体结果
下面主表里,Mac Gemma 已更新为加了合法答案约束后的完整重测。Grok 和 Qwen 397B 后来还有单题补跑,放在后面单独说明,没有把补跑成功悄悄替换进主表。
| 模型 / 部署 | 成功 | 超时 | 错误 | 三题总点击 | 动作总耗时 |
|---|---|---|---|---|---|
| Jev | 3/3 | 0 | 0 | 16 | 181.554 秒 |
| SemIf(Mac) | 2/3 | 1 | 0 | 202 | 4938.167 秒 |
| Laya MLX(Mac) | 0/3 | 3 | 0 | 1788 | 10801.153 秒 |
| Gemini 3.8 Flash | 3/3 | 0 | 0 | 13 | 454.317 秒 |
| Grok Chat Fast(修复轮) | 2/3 | 0 | 1 | 20 | 1595.756 秒 |
| DeepSeek Flash(非思考) | 3/3 | 0 | 0 | 27 | 322.163 秒 |
| GPT-OSS 20B(low) | 2/3 | 0 | 1 | 30 | 647.607 秒 |
| GPT-OSS 120B(默认思考) | 3/3 | 0 | 0 | 13 | 283.818 秒 |
| Qwen 3.5 397B(首轮) | 2/3 | 0 | 1 | 16 | 417.960 秒 |
| Qwen 3.5 4B(Mac,4-bit) | 2/3 | 1 | 0 | 292 | 6549.184 秒 |
| Gemma 4 E4B(Mac,4-bit,约束) | 2/3 | 1 | 0 | 303 | 5824.137 秒 |
| Qwen 3.5 4B(Kaggle,FP16) | 3/3 | 0 | 0 | 94 | 1150.229 秒 |
| Gemma 4 E4B(Kaggle,FP16,约束) | 3/3 | 0 | 0 | 55 | 734.523 秒 |
这里的“错误”可能是输出格式、非法候选编号或接口异常,不等于模型已经尝试完整选路但找不到目标。另外,API 型号按服务返回的名称记录,我没有独立验证服务商底层使用的权重。
具体到每道题:
| 模型 / 部署 | DNA | Music | World War II |
|---|---|---|---|
| Jev | 成功;5 次;49.118 秒 | 成功;7 次;68.786 秒 | 成功;4 次;63.650 秒 |
| SemIf(Mac) | 成功;8 次;332.980 秒 | 成功;38 次;996.774 秒 | 超时;156 次;3608.413 秒 |
| Laya MLX(Mac) | 超时;570 次;3600.306 秒 | 超时;519 次;3600.267 秒 | 超时;699 次;3600.580 秒 |
| Gemini 3.8 Flash | 成功;4 次;118.396 秒 | 成功;5 次;130.228 秒 | 成功;4 次;205.693 秒 |
| Grok Chat Fast(修复轮) | 成功;7 次;405.709 秒 | 成功;12 次;751.478 秒 | 错误;1 次;438.569 秒 |
| DeepSeek Flash(非思考) | 成功;5 次;46.445 秒 | 成功;9 次;102.674 秒 | 成功;13 次;173.044 秒 |
| GPT-OSS 20B(low) | 错误;7 次;167.063 秒 | 成功;10 次;145.328 秒 | 成功;13 次;335.216 秒 |
| GPT-OSS 120B(默认思考) | 成功;4 次;58.084 秒 | 成功;5 次;95.754 秒 | 成功;4 次;129.980 秒 |
| Qwen 3.5 397B(首轮) | 成功;6 次;88.114 秒 | 成功;8 次;105.163 秒 | 错误;2 次;224.683 秒 |
| Qwen 3.5 4B(Mac,4-bit) | 成功;34 次;735.415 秒 | 超时;173 次;3601.176 秒 | 成功;85 次;2212.593 秒 |
| Gemma 4 E4B(Mac,4-bit,约束) | 成功;20 次;416.351 秒 | 超时;178 次;3600.489 秒 | 成功;105 次;1807.297 秒 |
| Qwen 3.5 4B(Kaggle,FP16) | 成功;17 次;146.333 秒 | 成功;47 次;674.448 秒 | 成功;30 次;329.448 秒 |
| Gemma 4 E4B(Kaggle,FP16,约束) | 成功;10 次;124.544 秒 | 成功;17 次;213.880 秒 | 成功;28 次;396.099 秒 |
Gemma 最初三题全错,后来发生了什么
我最初写这篇的时候,Gemma 的结果还是 0/3。不过那一轮的主要问题是它不按要求返回合法的候选编号:连续给出过 --、None、-1,程序自然不能拿这些答案去点击。
这一轮三题分别只走了 0、1、0 步,总共 186.311 秒就因错误结束了。所以不能把这个很短的时间当成“跑得快”,也不能据此认定它完全不会选路。
后来我加了一个解码约束:模型只能生成当前候选编号对应的 JSON 答案,合法 token 的分数还是模型自己决定。它限制的是答案格式和可选范围,没有告诉模型哪条路正确,也没有改题目或候选链接。
加约束后,Mac 上的 Gemma 完成了 2/3,Music 仍然跑满一小时超时。说明格式问题解决以后,选路能力才真正有机会被测出来;但格式稳定,不代表一定能到终点。
这也意味着,原来的无约束结果和新的约束结果需要分开看。当前 Qwen 没有使用同样的解码约束,只做生成后的校验和修复,所以两者也不能说所有输出条件完全一致。
换到 Kaggle,究竟快了多少
先看相同输入的推理耗时。这里固定每组 255 个候选,预热后测三次取中位数。对应的 Mac 和 Kaggle 原生提示词文本、输入 token ID 都做过一致性核对。
| 部署 | DNA | Music | World War II |
|---|---|---|---|
| Qwen 3.5 4B(Mac,4-bit) | 16.460 秒 | 15.487 秒 | 16.477 秒 |
| Qwen 3.5 4B(Kaggle,FP16) | 6.302 秒 | 6.430 秒 | 7.024 秒 |
| Gemma 4 E4B(Mac,4-bit,约束) | 10.485 秒 | 9.957 秒 | 10.905 秒 |
| Gemma 4 E4B(Kaggle,FP16,约束) | 8.298 秒 | 8.142 秒 | 8.850 秒 |
Qwen 在这三组固定输入上约快了 2.35–2.61 倍,Gemma 约快了 1.22–1.26 倍。两套 Kaggle 部署的九次测速输出都有效,把目标放在不同候选位置的九个检查也都通过了。
但这里还不能说是纯粹的“GPU 比 Mac 快多少”:Mac 用的是 MLX 4-bit,Kaggle 用的是 Transformers FP16,精度和运行框架都变了。云端首次下载和加载权重也要花时间,这些没有算进上面的单次推理耗时。
更有意思的是完整任务结果。Kaggle 上 Qwen 三题全过,94 次点击,用时约 19 分 10 秒;Gemma 也三题全过,但只用了 55 次点击,约 12 分 15 秒。
Gemma 单次选择比 Qwen 慢,这次完成整套任务却更快。 它少走了约 41.5% 的步数,动作总时间少了约 36.1%。所以这类任务不能只盯着一次推理几秒:选错方向以后,再快的推理也可能用来绕路。
不过,Gemma 这次更短的路线也不能全部归功于换了 GPU。两边权重精度和数值实现不同,实时网页也不是完全静止的环境。现在能说的是:这套 Kaggle FP16 部署在本轮三题上取得了更好的实际结果。
部署过程也不是点一下就跑通。T4 的精度和 attention 配置、Gemma 的双卡权重分配,都踩过显存问题;修好以后才完成正式测试。两套最终结果都已经下载,保存的模型调用和路线也复核过了。这次实际用的是 Kaggle,Colab 还没测。
有两次 API 补跑,也需要单独说
Grok 和 Qwen 397B 的二战题后来把单次 HTTP 请求等待从 60 秒改成 300 秒,从起点重新跑,最后都成功了:
| 配置 | 二战补跑 | 保留前两题后的合计 |
|---|---|---|
| Qwen 3.5 397B | 成功;8 次;153.294 秒 | 3/3;22 次;346.571 秒 |
| Grok Chat Fast(修复轮) | 成功;4 次;656.779 秒 | 3/3;23 次;1813.966 秒 |
这些合计来自两次运行,不是一套全新、统一等待时间的三题测试,因此我没有用它们覆盖主表。调长等待后成功,也不能仅凭这一次就断言原先的失败只由等待时间造成。
GPT-OSS 120B 也试过 low 思考设置:固定输入变快了,但正式三题变成 2/3,二战题因 JSON 格式错误结束。主表保留默认思考的 3/3。这个结果同样说明,少思考、返回得快,不一定等于整套任务更好。
跑完之后,我现在怎么看
我对 Jev 的第一印象还是不错的。在这三道题里,它全部成功,16 次点击、约 3 分 2 秒,是主表中三题全过的配置里动作总耗时最短的。固定 255 候选的三个样本中位数也都在 0.5 秒左右。
但它不是点击最少的:GPT-OSS 120B 默认设置和 Gemini 都只用了 13 次,分别约 4 分 44 秒和 7 分 34 秒。Jev 的优势在于这轮完成得快,不能直接说它在所有指标上都赢了。
对自己部署的小模型,我也得修正最初的判断。不能笼统说“本地模型都不行”,或者把问题都归到 Mac 太慢。至少这次,Qwen 4B 和 Gemma E4B 换到 Kaggle 之后都完成了三题;其中 Gemma 在近期这几套自部署小模型里整体最好,但它还没有超过主表里那些表现好的 API 方案。
至于价格,我当时确实觉得 Jev 值得试,但这轮没有整理出覆盖所有服务商、失败请求和重试的完整账单,所以还不能严谨地下“哪个最便宜”的结论。Kaggle GPU 的小时额度和界面上的 AI 推理美元额度也是分开的,不能混着算。
我原本还猜测,本地跑一个 27B 左右的模型可能就能达到 Jev 的效果。现在看,这还是个需要验证的猜测,不能拿这几组 4B 级模型的结果直接推出。更值得继续测的是:相同精度下换运行平台,再增加题目和重复次数,看看这些差距能不能稳定出现。
毕竟这里只测了三道题,每个主表配置每题一次。模型的格式可靠性、选路质量、推理速度和网络状况,都会一起影响最终成绩。它能说明我这套程序这次跑出来的结果,还不够当作通用模型排行榜。